

코난 타임스
헌책방의 'AI 퇴직금'? 본문
📰 한 줄 브리핑
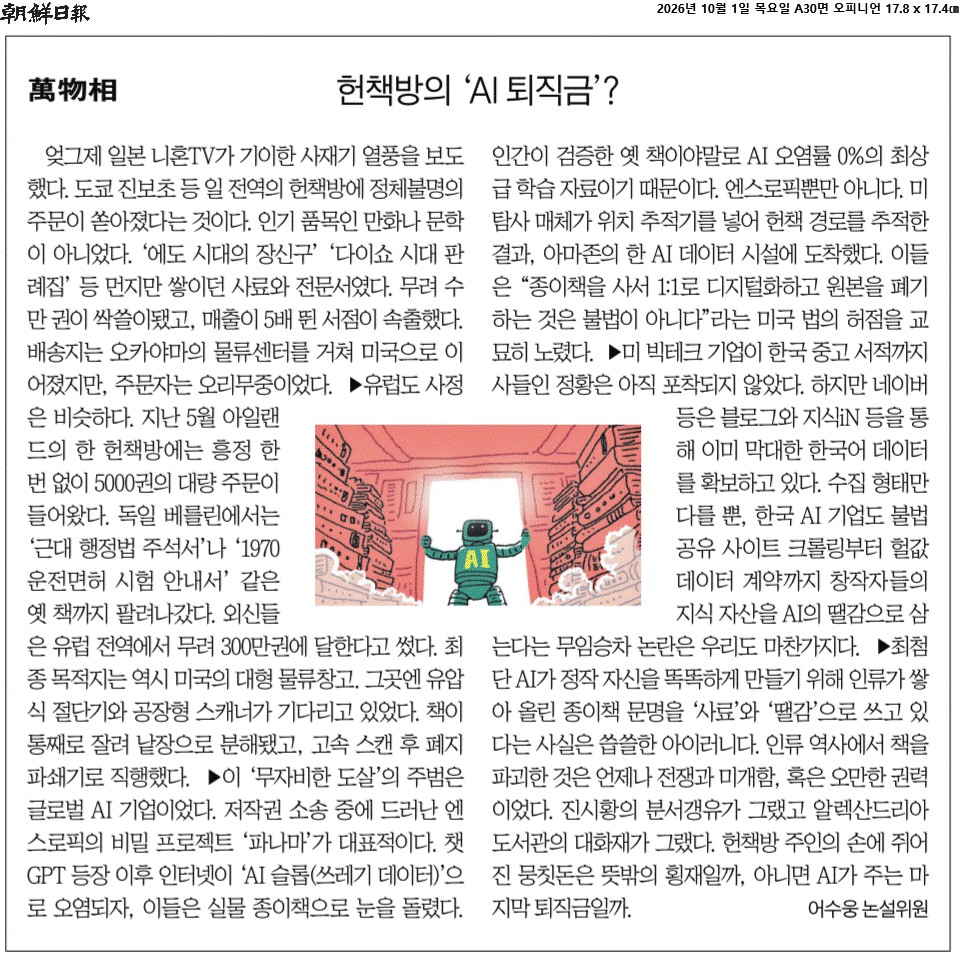
AI 기업들이 저작권 문제를 피하면서 고품질 학습 데이터를 확보하기 위해 전 세계 헌책을 대량 구매해 디지털화하고 있다. 한때 사라질 것으로 여겨졌던 종이책이 오히려 AI 시대의 핵심 원재료가 되면서 헌책방에 뜻밖의 ‘AI 특수’가 찾아왔다는 이야기다.
✅ 5줄 요약
- 일본·유럽의 헌책방에 최근 수천~수만 권 단위의 주문이 들어오고 있으며, 주문자는 미국을 중심으로 한 글로벌 AI 기업들로 추정된다.
- 책들은 미국의 대형 물류창고로 보내져 절단 → 고속 스캔 → 폐기되는 방식으로 디지털 데이터로 변환된다.
- 생성형 AI 등장 이후 인터넷에 AI 생성물이 늘어나자 기업들은 오염되지 않은 고품질 인간 작성 데이터를 찾기 시작했고, 오래된 종이책이 주목받았다.
- 기사에 따르면 미국에서는 중고책을 사서 디지털화한 뒤 원본을 폐기하는 방식이 저작권과 관련해 활용되고 있으며, AI 기업들의 종이책 확보 경쟁으로 이어졌다.
- 칼럼은 이를 한국과도 무관하지 않은 문제로 보며, 국내 플랫폼·AI 기업 역시 방대한 한국어 데이터와 창작물의 이용을 둘러싼 논쟁에서 자유롭지 않다고 지적한다.
🔢 핵심 숫자
수만 권 — 일본 한 헌책방에 들어온 주문 규모.
5000권 — 아일랜드의 한 헌책방에 한 번에 들어온 대량 주문.
300만 권 — 유럽 전역에서 사들였다는 책 규모로 칼럼이 소개한 수치.
흥미로운 것은 책의 가격보다 책 안의 데이터 가치가 커졌다는 것이다.
💡 코난의 통찰
① 가장 재미있는 역설은 이것이다 — AI가 발전할수록 인간이 쓴 옛 글이 귀해진다
인터넷에는 데이터가 넘친다.
그런데 생성형 AI가 만든 글이 인터넷에 급증하면서 문제가 생긴다.
Human Data → AI 학습 → AI Content 증가 → 인터넷 데이터 오염 → Human Data 희소성 증가
AI가 데이터를 풍부하게 만드는 동시에 AI가 쓰지 않은 데이터를 희소하게 만드는 역설이다.
② 그래서 헌책은 ‘중고 상품’에서 AI 원자재로 변한다
예전 헌책의 가치는
희귀성 + 보존상태 + 독서가치
였다.
AI 기업에는 다르다.
인간이 직접 썼는가
AI 이전에 만들어졌는가
디지털화되지 않았는가
전문적인 지식이 들어 있는가
가 중요하다.
Old Book → Clean Human Data
책의 용도가 완전히 달라진 것이다.
③ 이것은 일종의 ‘데이터 광산’ 발견이다
AI 시대에는 기존에는 별 가치가 없다고 생각했던 자료가 갑자기 자산이 될 수 있다.
절판 서적
옛 신문
잡지
논문
방송 원고
기업 문서
사진 아카이브
등이다.
Archive → Digitization → Structured Data → AI Asset
앞서 이야기했던 ‘이미 가지고 있는데 돈을 받고 있지 않은 자산을 찾는다’는 관점과 정확히 연결된다.
④ 특히 신문사의 오래된 아카이브는 다시 볼 필요가 있다
신문에는 수십 년간 축적된
기사 + 사진 + 인물 + 사건 + 날짜 + 장소 + 문체 + 사회적 맥락
이 있다.
단순히 옛날 기사를 검색하는 DB가 아니다.
AI 관점에서는 시간축을 가진 고품질 인간 데이터 세트가 될 수 있다.
즉 과거에는
Archive = 보관 비용
이었다면 앞으로는
Archive = Data Asset
이라는 관점이 가능하다.
⑤ 더 중요한 것은 ‘원문’보다 맥락이 붙은 데이터일 수 있다
책을 스캔하는 것보다 더 가치 있는 데이터는 구조화된 데이터다.
예를 들어 신문이라면
기사 + 날짜 + 기자 + 섹션 + 제목 + 관련 사진 + 후속 기사 + 정정 기사
가 연결돼 있다.
이렇게 맥락이 붙으면 AI가 단순히 문장을 배우는 것이 아니라 사건과 시간의 관계까지 학습하는 데 활용될 수 있다.
Raw Data < Structured Data < Contextual Data
⑥ AI가 만든 데이터로 AI를 계속 학습시키는 데는 위험이 있다
칼럼에서 말하는 ‘AI 슬롭’의 핵심도 여기에 있다.
AI가 만든 글을 다시 AI가 학습하고, 그 AI가 다시 글을 만들면
AI → AI Data → AI → AI Data
라는 폐쇄적 순환이 생길 수 있다.
그래서 AI 이전의 인간 창작물은 일종의 데이터 원본에 가까운 가치가 생긴다.
⑦ 앞으로 ‘AI 이전에 만들어졌다’는 것이 일종의 인증이 될 수도 있다
사진에서는 이미 비슷한 문제가 생기고 있다.
글에서도 앞으로
Pre-AI Content
라는 개념이 중요해질 가능성이 있다.
AI 생성 여부를 의심할 필요가 없는 1990년대 신문, 1980년대 책, 1970년대 잡지는 태생적으로 Human-Origin Data다.
오래됐기 때문에 가치가 떨어지는 것이 아니라 오래됐기 때문에 출처가 확실해지는 역설이다.
⑧ 결국 저작권의 경제적 가치도 바뀔 수 있다
과거 저작권의 주된 경제적 가치는
사람에게 얼마나 많이 읽히는가
였다.
AI 시대에는 여기에 새로운 가치가 붙는다.
AI가 얼마나 학습하고 싶어 하는가
따라서 책·신문·사진·음악 같은 콘텐츠 기업에는
Human Audience Value + Machine Learning Value
라는 두 시장이 생길 가능성이 있다.
물론 실제 학습 이용 가능 범위와 대가는 각국의 저작권법과 계약에 따라 달라진다.
⑨ 여기서 가장 중요한 자산은 ‘콘텐츠’보다 권리까지 정리된 콘텐츠일 수 있다
AI 회사가 원하는 데이터가 있어도 저작권 관계가 복잡하면 사용하기 어렵다.
따라서 미래에는
콘텐츠 보유량 × 데이터 품질 × 메타데이터 × 권리 정리
가 함께 중요해질 수 있다.
아카이브가 많다고 자동으로 AI 자산이 되는 것은 아니다.
AI-ready Archive = Content + Metadata + Rights
이 구조가 핵심이다.
⑩ 결국 AI 시대에는 ‘오래된 것’의 가치가 역전될 수 있다
최신 데이터는 많다.
하지만 최신 인터넷에는 AI가 만든 정보도 계속 섞인다.
반대로 오래된 책과 신문에는 인간이 직접 관찰하고 생각하고 쓴 흔적이 남아 있다.
그래서 역설적으로
AI가 많아질수록 인간이 만든 원본의 희소성은 커진다.
앞서 살펴본 ‘날것의 인간 흔적’이 AI 시대에 더 가치 있어진다는 현상과도 정확히 맞닿아 있다.
🔚 코난의 한줄
헌책방의 AI 특수는 단순한 재미있는 해외 토픽이 아니다. AI가 세상의 데이터를 무한히 늘려놓을수록 오히려 AI가 만들지 않은 데이터가 희소해진다는 역설을 보여준다. 그런 의미에서 수십 년간 축적된 책·신문·사진·잡지·방송 아카이브는 낡은 자료가 아니라 AI 시대의 새로운 원자재가 될 수 있다. 미래의 데이터 경쟁에서 중요한 것은 최신 자료를 얼마나 많이 만드는가뿐 아니라, 얼마나 오래되고 신뢰할 수 있는 ‘인간의 원본’을 가지고 있는가일지도 모른다.
🔑 핵심 키워드
#AI #헌책 #학습데이터 #AI슬롭 #저작권 #아카이브 #신문아카이브 #HumanData #PreAI #데이터자산
[만물상] 헌책방의 ‘AI 퇴직금’?
미국 AI 기업들이 인터넷 데이터의 신뢰도 저하를 극복하고자 전 세계 헌책을 대량 매입해 디지털화한 뒤 폐기하고 있음. 이러한 행태는 인류 지식 자산의 무분별한 소모라는 비판을 받으며, AI
www.chosun.com
'진실은 언제나 하나뿐! 코난 타임스!' 카테고리의 다른 글
| 취업 자소서 대신 서술형 문답 40개, 온라인 인터뷰까지 (0) | 2026.10.04 |
|---|---|
| 다시 금 사는 중앙은행들, 뉴욕 아닌 런던에 쌓아둔다 (0) | 2026.10.03 |
| AI, 신, 무당 (0) | 2026.10.03 |
| AI 답변 받으려다 기밀이 술술 (0) | 2026.10.03 |
| "AI로 해고된 직원 30% 재고용" (1) | 2026.10.03 |


